当你建立了一个模型后,肯定想知道这个模型是好还是坏,就像你完成了一项工作,也需要评价你的工作完成得好不好。前面我们介绍了一系列评价模型优劣的指标如AIC、BIC、MSE 等。但这些指标一般是对数据自身的评价,也就是说,你用一份样本数据建立了模型,然后将模型回代到该样本数据,再来验证该模型的有效性。在这种情况下,通常验证效果会比较好,但这未必真的说明该模型有效。
打个比方,你根据自己的家庭布局发明了一个扫地机器人,它可以把你家的每个角落都打扫得干干净净。看起来不错,但是有一个问题,如果把它放到别人的家中那么由于家庭布局不同,它的打扫效果就很一般了。也就是说,你是根据自己的家庭布局发明的,它只适合你的家庭布局,但却并非适合所有的家庭布局。所以,这算不上一个好的机器人,一个好的机器人应该在所有的环境下都能发挥作用。
从专业上来讲,这就是一个偏差一方差权衡同题、你的扫地机器人对自己家的打扫效果非常好(如99%)说明偏差非常低,但是放到别人的家中打扫效果很地般(如60%),说明方差很大(因为不同家庭的打扫效果差别很大)。只追求偏差而忽略方差,说明推广性不强,如果反过来,有一个扫地机器人在每一家的打扫效果都不算非常好,但都比较稳定(如在每一家都为 80%左右),则说明它的方差很小,但偏差相对较大(因为每一家的打扫效果都不算太好)。
同样的道理,如果你建立了一个模型,怎样才能说明它的好坏? 只是回代效果好 (偏差小)并不意味着真的有效,还需要把它用于新的数据中进行验证。如果验证的结果仍然很好(方差小),就说明模型有效。然而,这一思路说起来简单,做起来就比较困难了。因为实际中的样本数据通常只调查或测量一次,很少进行重复抽样,所以很难在新的数据中进行验证。试想:你要研究高血压的危险因素,调查了 2000 人建立模型,一般不大可能再调查 1000 人来验证这一模型。
交叉验证法(Cross Validation,CV)正是解决这一问题的技术,它先把n例调查数据随机分为k份,以其中的k-1份数据作为训练集 (Training Set),建立模型;然后以剩余的1份数据作为验证集 (Validation Set),验证模型的优劣。经过这种方式验证的效果通常更具有说服力,因为建立模型的数据和验证模型的数据不同。
验证一个模型的好坏,严格来说是把数据分为 3 份:训练集用来建立模型,验证集用来比较模型优劣并筛选模型,还有一个测试集 (Test Set)用来检验模型推广的能力。通常我们所说的把数据按一定比例(如7:3)分为两份,一份是训练集,一份就是测试集,把训练集中建立的模型应用到测试集中,看其效果如何。而在交叉验证中我们通常在训练集中建模,然后利用验证集对模型进行调整和筛选。
交叉验证法可广泛应用于对包括线性模型在内的各种模型的评价,而且可以用于某些参数的确定、变量的筛选等,因为它是一种思路,而不是一种固定的方法。后面我们会在其他内容中继续用到该方法。交叉验证主要有以下几种情形:
(1)当k=n时,等同于把n 例数据分为n份,以其中的n-1 例作为训练集,以剩下的1例作为验证集,这种方法称为留一 (Leave One Out)交叉验证法。例如,编号为1~100的数据,先以第 1~99 号数据作为训练集建立模型,将第 100 号数据代入模型,可计算第 100 号数据的预测值与实际值的差异(如MSE);然后以第1~98、100号数据作为训练集建立模型,将第 99 号数据代入模型,计算第 99 号数据的MSE;按着以第 1~97、99、100 号数据作为训练集建立模型,将第 98 号数据代入模型,计算第98号数据的MSE;····”。这样重复100 次,相当于建立 100 个模型,可以计算 100个MSE,然后得到这 100个MSE的均值。
(2)当k为其他值时,一般称为k折 (k Folds) 交又验证法。如当k=10时,相于把数据集分为 10 份,先以第 1~9 份数作为训练集建立模型,以第 10 份数据作为验证集,可以观察模型的 MSE: 然后以第 1~8、10 份数据作为训练集,以第9 份数据作为验证集,观察模型的 MSE:··…。这样重复 10次,最终也可以计算出 10次MSE的均值。
实际中是选择留一交验证法还是k 折交叉验证法呢? 这仍需要考虑到偏差-方差权衡问题。一般而言,随着K的增加,偏差会变小,但方差会增大。因此,留一交叉验证法估计的偏差较小,因为训练集比较大,但同时带来方差的增大,因为每次都用到N-1 例数据拟合模型,这些结果之间必然存在高度相关。而且在样本量很大时,留一交又验证法的计算量太大。Hastie 等 (2001)推荐采用 10 折或5折交验证法作为较好的折中。
以生活中的数据为例,我们曾以R^2(adj)为标准进行最优子集选择,结果发现age+course、age+course+ht、agetcourse+wt、coursetwt、agetcoursetht+wt 这 5 个模型似乎差别不大。现在我们用 10 折交叉验证法来看一下,这5个模型到底哪个最好。
表 1分别给出了数据回代和交叉验证法给出的MSE。可以看出,回代结果与以R^2(adj)为标准的选择结果一致,R越大的模型,其MSE越小。但交叉验证结果并不完全一致,如 course+wt 模型与 coursetwt+age 模型,从回代结果来看,后者更好(MSE更小):但从交叉验证结果来看,则前者更好。这种情况在实际中并不少见,即多个变量的回代效果较好,但交叉验证效果未必更好。因为变量越多,可能其偏差越小,但方差可能会随之增大,所以在自身验证时会显得效果较好,但新数据的验证则未必。
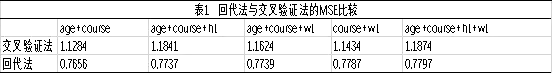
从结果中还可以看出一个特点,即交叉验证法的 MSE总是高于回代法。这很容易理解,将模型用于自身数据,误差必然较小: 而用于一份新的数据,误差肯定较大。
交叉验证是一种思路,实现方式有很多种,我这里给出sas的宏程序,感兴趣的读者可以自取。
%Macro cv(seed=,data=,k=,Y=,var=,nvar=);
/*data 指定数据,seed 指定种子数,k 指定几折交叉,y 指定因变量,var 指定自变量,nvar指定自变量的数目*/
data vd;
set &data.;
call streaminit(&seed.);
ran=cei1(&k.*rand(“uniform”));
run;
%Do i = 1 to &k:
%DO:
data train &i. valid &i.;
set vd;
if ran=&i. then output valid &i.;
else output train &i.;
run;
proc reg data=train_&i. noprint;
model &y.=&var.;
store param;
run;
proc plm restore=param;
score data=valid &i. out=res &i. residual=res;
run;
%END;
%End;
data res;
set res_l-res_&k.;
res2=res**2;
run;
proc sql;
select ran,sum(res2)/(n(res2)-(&nvar.+l)) as mse from res
/*计算MSE,分母中的n(res2)表示例数,(&nvar.+1)表示变量数+截距*/
group by ran;
quit;
%mend cv;

关于作者